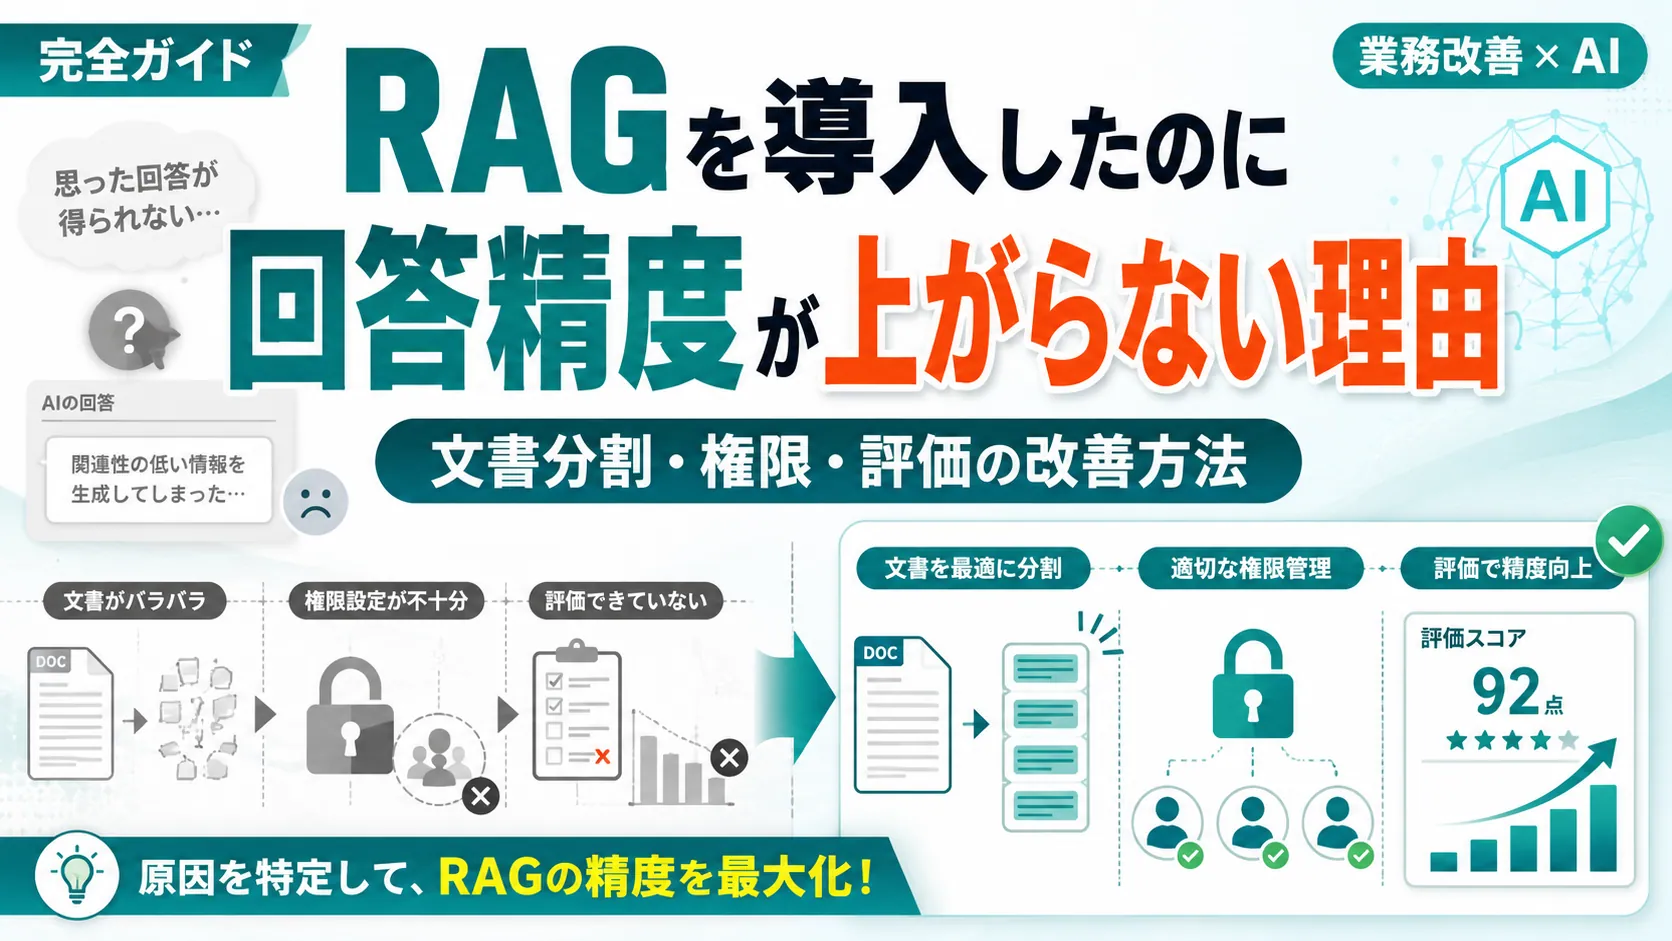
RAGを導入したのに回答精度が上がらない理由―― 文書分割・権限・評価の改善方法
無料相談 / RAG精度改善
「RAGを導入したが精度が上がらない」という課題は、検索結果の確認から原因を切り分けられます。文書分割・検索・権限・評価の改善をワンストップで支援します。
無料で相談する →- RAGの精度は「生成AIモデルの性能」だけでなく、文書整備・検索設計・権限設計・評価運用を含むシステム全体で決まります。
- 多くの場合、生成AIが答えられないのではなく、回答に必要な情報が生成AIまで届いていないことが原因です。
- 精度が低いときは、生成AIモデルを変える前にまず検索結果を確認。正解文書が取得できていないならプロンプト改善では解決しません。
- 文書分割・PDF読み取り・鮮度・検索方式・権限・リランキング・評価を一つの改善サイクルとして回し続けることが、業務で使えるRAGへの道です。
RAGを導入しても精度が上がらないという悩み
「社内文書を生成AIに読み込ませたのに、期待した回答が返ってこない」「資料には書いてあるはずなのに、"情報が見つかりません"と回答される」「同じ質問をしても、回答内容が毎回微妙に変わる」。社内FAQや問い合わせ対応、マニュアル検索、営業支援などを目的にRAGを導入したものの、思ったほど回答精度が上がらず、困っている企業は少なくありません。
RAGは、社内文書を登録すれば自動的に高精度なAIが完成する仕組みではありません。重要なのは、文書をどのように読み取り、どの単位で分割し、どの情報を検索し、どの権限で参照させ、回答品質をどのように評価するかです。
RAGとは?
RAGとは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」などと呼ばれます。ユーザーから質問を受け取った際に、社内文書やデータベースから関連情報を検索し、その情報を生成AIに渡して回答を作らせる仕組みです。一般的なRAGは、次の流れで動作します。
- 社内文書を読み込む
- 文書を小さな単位に分割する
- 分割した文章を検索可能な状態にする
- ユーザーの質問に近い文章を検索する
- 検索結果を生成AIに渡す
- 生成AIが回答を作成する
RAGによって、生成AIが学習していない社内情報や最新情報を参照できるようになり、回答の根拠を示しやすくなります。しかし、この流れのどこかに問題があると、正しい資料を登録していても、適切な回答は返ってきません。
RAGを導入しても回答精度が上がらない7つの理由
RAGの精度が低いとき、すぐに生成AIモデルやプロンプトを変更したくなります。ところが実際には、「生成AIが正しく答えられない」のではなく、「回答に必要な情報が生成AIまで届いていない」ケースが多くあります。代表的な原因を見ていきましょう。
理由1:文書の分割方法が適切ではない
RAGでは、PDFやWord、社内マニュアルなどを、そのまま検索するわけではありません。多くの場合、文書を「チャンク」と呼ばれる小さな単位に分割してから、検索用のインデックスに登録します。この文書分割が適切でないと、回答に必要な情報が途中で切れたり、無関係な情報と混ざったりします。
チャンクが小さすぎる場合:例えば「出張費の申請は、帰社後5営業日以内に行う。ただし、海外出張の場合は10営業日以内とする。」という規定が途中で分割されると、RAGが「5営業日以内」という部分だけを検索し、海外出張の例外条件を見落とす可能性があります。
チャンクが大きすぎる場合:反対に、数ページ分を一つのチャンクにまとめると、検索対象に無関係な情報が大量に含まれます。生成AIに渡される情報量が増えても、必要な情報が埋もれてしまえば、回答精度は上がりません。
改善方法:一定文字数で機械的に分割するだけでなく、見出し単位/章・節単位/質問と回答のセット/規定本文と例外条件/表のタイトルと内容/製品名・型番と仕様/業務手順の開始から完了まで、といった構造を考慮します。重要なのは「何文字で分割するか」ではなく、「一つのチャンクだけを読んでも意味が成立するか」です。就業規則、製品マニュアル、議事録、FAQ、契約書では適切な分割単位が異なるため、すべての文書に同じ分割ルールを適用する必要はありません。
理由2:PDFや表を正しく読み取れていない
「文書は登録できているから問題ない」と考えるのは危険です。システム上は登録済みでも、PDFの読み取り順序が崩れている/2段組みの文章が混ざっている/表の行と列の関係が失われている/ヘッダーやフッターが本文に混入している/スキャンPDFを文字として認識できていない/図表内の重要情報が欠落している/箇条書きの階層構造が失われている、という状態になっていることがあります。
特に、表形式の料金表、仕様書、契約条件、業務フローは注意が必要です。元の表では「プラン名」「料金」「対象人数」が正しく並んでいても、テキスト変換後に順序が崩れると、生成AIが別のプランの料金を回答してしまう可能性があります。
改善方法:RAGに登録する前に、抽出されたテキストを必ず確認します。見出しと本文が正しく対応しているか/表が意味の通る形式に変換されているか/ページをまたぐ文章が分断されていないか/OCRの誤認識が発生していないか/図や注釈の情報が欠落していないか/古いヘッダーや管理番号が検索を邪魔していないか。RAGの精度改善では、生成AIモデルを変えるより、文書の前処理を改善した方が大きな効果を得られることがあります。
理由3:古い文書や重複文書が混在している
RAGは、登録された文書の内容が正しいかどうかを自動的に判断してくれるわけではありません。2024年度版・2025年度版・2026年度版の経費規程、改訂前後の業務マニュアル、部門ごとにコピーされた同一ファイルが同時に登録されていると、古い規定が検索結果に含まれ、現在とは異なる回答が生成される可能性があります。RAGは「社内文書をたくさん登録するほど賢くなる」とは限らず、古い情報・重複情報・矛盾した情報が増えるほど検索精度が下がることがあります。
改善方法:文書ごとに、文書名/文書種別/対象部署/対象製品/公開日/改訂日/有効期限/バージョン/管理責任者/公開・非公開の状態、といったメタデータを付与します。検索時には「最新版のみ」「対象部署のみ」「有効期限内のみ」といった条件で絞り込みます。文書を登録するだけではなく、「どの文書を正として扱うのか」を決めることが重要です。
理由4:ベクトル検索だけに頼っている
RAGでは、文章の意味的な近さを使うベクトル検索がよく利用されます。しかし業務上の質問では、意味の近さだけでなく、完全一致に近い検索が必要になることがあります。製品型番・エラーコード・契約番号・部品番号・プラン名・社内制度の正式名称・固有の略語・人名や部署名などです。「AB-1200」と「AB-120O」のような型番は、意味的には近く見えても、業務上はまったく別の製品かもしれません。このようなケースでは、ベクトル検索とキーワード検索を組み合わせる「ハイブリッド検索」が有効です。
改善方法:質問の種類に応じて検索方法を使い分けます。意味の近い内容を探す→ベクトル検索/型番や正式名称を探す→キーワード検索/特定部署や年度に絞る→メタデータフィルター/複数結果を並べ替える→リランキング/複雑な質問を分解する→クエリ分解/略語を正式名称に変換する→クエリ書き換え。例えば「A商品の2026年度の保証期間と、故障時の申請方法を教えて」という質問には保証規定と申請マニュアルの両方が必要で、一回の検索ではなく質問を複数の検索クエリに分解する設計が必要になることもあります。
理由5:権限設計によって必要な文書が検索されていない
RAGの権限設計では、主に二つの問題が発生します。一つは、本来閲覧できる文書が検索対象から外れてしまうこと。もう一つは、本来閲覧できない機密文書が回答に使われてしまうことです。人事評価情報・個人の給与情報・経営会議資料・顧客別の契約金額・未発表の製品情報・法務・監査関連資料などを全社員向けRAGにまとめて登録すると、情報漏えいにつながる可能性があります。そのため、ユーザーの部署・役職・プロジェクト・雇用区分などに応じて、検索可能な文書を制御する必要があります。
権限は回答生成後ではなく検索時に制御する:危険なのは、機密文書を検索した後、生成AIに「このユーザーには機密情報を見せないでください」と指示する設計です。一度生成AIに機密情報を渡してしまうと、回答に一部が混入するリスクがあります。原則として、ユーザーが閲覧できない情報は、生成AIに渡す検索結果にも含めない設計が必要です。
改善方法:文書ごと、またはチャンクごとに、閲覧可能な部署/役職/ユーザー/プロジェクトID/顧客ID/機密区分/公開範囲/有効期間を持たせ、ログインユーザーの権限情報を検索条件に加えます。権限設定が厳しすぎると本来必要な文書まで検索できなくなるため、「回答が見つからない」問題が検索精度ではなく権限設定によるものではないか、検索ログと権限ログを分けて確認できるようにしておきましょう。
理由6:検索結果をそのまま生成AIに渡している
検索で取得した上位の文章が、すべて回答に必要とは限りません。関連度の低い文章や、同じ内容の重複チャンクが上位に並ぶこともあります。そこで重要になるのが「リランキング」です。リランキングとは、最初に広めに取得した検索結果を、質問との関連度に基づいてもう一度並べ替える処理です。例えば、最初の検索で20件を取得し、その後、関連度の高い5件に絞って生成AIに渡します。これにより、回答に不要な情報を減らし、重要な根拠を優先的に使わせることができます。
また、単純に上位のチャンクだけを渡すのではなく、前後の文章や親階層の情報を追加する方法もあります。検索時には小さな子チャンクを使い、最終的にはより広い親チャンクに置き換える「階層型チャンク」で、検索の細かさと回答に必要な文脈の両立を図る手法もあります。
理由7:回答精度を評価する仕組みがない
RAG導入で最も大きな問題の一つが、「何をもって精度が高いと判断するか」が決まっていないことです。担当者が数回質問し「なんとなく回答できている」と確認するだけでは、改善すべき場所が分かりません。RAGは、大きく「検索の評価」と「回答生成の評価」に分けて評価する必要があります。
| 1. 検索の評価 | 2. 回答生成の評価 |
|---|---|
| 正解の文書が検索結果に含まれているか | 質問に正しく答えているか |
| 正解チャンクが上位に表示されているか | 検索結果に基づいて回答しているか |
| 不要な文書が大量に混ざっていないか | 文書にない内容を作っていないか |
| 最新版の文書が優先されているか | 根拠となる出典が正しいか |
| 権限外の文書が含まれていないか | 情報がない場合に無理に回答していないか |
テスト質問を作る:まずは実際の利用者が聞く質問を50〜100問程度集めます。文書に明確な答えがある質問/複数の文書を横断しないと答えられない質問/数値や日付を正確に答える必要がある質問/例外条件を含む質問/略語や口語表現を含む質問/文書に答えが存在しない質問/閲覧権限によって回答が変わる質問、と種類を分けると効果的です。各質問に対して、正解、参照すべき文書、許容できる回答範囲を定義します。RAGを改善するたびに同じテストセットで評価すれば、変更によって本当に精度が上がったのかを確認できます。
RAGの回答精度を改善する7ステップ
RAGの精度が低いときは、生成AIモデルを変更する前に、次の順番で原因を切り分けます。
| ステップ | やること |
|---|---|
| 1. 質問と正解データを集める | 問い合わせ履歴・メール・チャット・ヘルプデスク記録から、ユーザーが本当に聞く質問を収集。開発者が想像した質問だけでは不十分 |
| 2. 検索結果を確認する | 回答だけでなく、裏側でどの文書が検索されたかを確認。正解文書が検索されていないならプロンプト改善では解決しない |
| 3. 原文と抽出テキストを比較する | PDFや表が正しく読み取られているか確認。壊れていればOCR・レイアウト解析・表の構造化を改善 |
| 4. チャンク分割を見直す | 意味・見出し・表・例外条件を考慮して分割。必要に応じてチャンクを重複させたり親子構造を持たせる |
| 5. 検索方式を改善する | キーワード検索・ハイブリッド検索・メタデータフィルター・リランキング・クエリ書き換え・クエリ分解・同義語/略語辞書を組み合わせる |
| 6. 権限と文書の鮮度を確認する | 最新版が検索されているか、権限で必要な情報が除外されていないか、権限外の文書が検索されていないかをテスト |
| 7. 回答生成の指示を改善する | 正しい検索結果が取れた後に、生成AIへの指示を改善 |
ステップ7で設定するルールの例:検索結果にない情報は推測しない/根拠となる文書名を表示する/複数の文書が矛盾する場合はその旨を伝える/情報が不足する場合は追加質問を行う/回答できない場合は担当部署を案内する/数値・日付・型番を省略しない/結論・根拠・手順の順に回答する。
RAGの精度改善でやってはいけないこと
とりあえず文書を大量に登録する
文書数を増やせば回答できる範囲は広がりますが、古い文書や重複文書も増えれば検索精度は低下します。登録前に整理、分類、更新、権限設定を行う必要があります。
すぐにLLMを変更する
高性能な生成AIモデルに変更しても、必要な情報が検索できていなければ正しい回答は作れません。先に検索結果を確認しましょう。
チャンクサイズだけを何度も変更する
チャンクサイズは重要ですが、それだけが精度を決めるわけではありません。文書の読み取り、メタデータ、検索方法、リランキング、権限、プロンプトも含めて評価する必要があります。
正解がない質問でも回答させる
業務用RAGでは、「答えられない」と適切に判断できることも重要な品質です。情報が存在しない質問に無理に答えると、もっともらしい誤回答が発生します。
担当者の感覚だけで評価する
「前より良くなった気がする」という評価では、改善を継続できません。テスト質問、正解データ、検索ログ、ユーザー評価を蓄積し、変更前後を比較できるようにします。
RAG導入の成否は「AI」より「運用設計」で決まる
RAGは、一度構築したら完成するシステムではありません。社内文書は日々更新され、組織変更や商品改定、規程改定によって、正しい回答も変化します。そのため、本番運用では次の役割を決めておく必要があります。
- 文書を更新する担当者/正式文書を承認する責任者
- 古い文書を削除する担当者/権限を管理する担当者
- 回答品質を評価する担当者/誤回答を修正する担当者
- 利用ログを分析する担当者
また、利用者が「回答が違う」「資料が古い」「必要な情報が出てこない」とフィードバックできる仕組みも必要です。RAGの精度は導入時の設定だけで決まるものではなく、利用ログから失敗パターンを発見し、文書・検索・権限・回答ルールを継続的に改善することで、初めて業務で使えるシステムに育っていきます。
RAG精度改善チェックリスト
現在のRAGに課題がある場合は、次の項目を確認してください。
| 領域 | チェック項目 |
|---|---|
| 文書・データ | 登録文書は最新版か/古い・重複文書が残っていないか/PDFや表を正しく読み取れているか/管理責任者が決まっているか/公開日・改訂日が設定されているか |
| 文書分割 | 一つのチャンクだけで意味が成立するか/見出しと本文が分離していないか/例外条件が別チャンクに分かれていないか/表のタイトルと内容が分離していないか/文書の種類ごとに分割ルールを変えているか |
| 検索 | 正解文書が検索結果に含まれるか/キーワード検索とベクトル検索を使い分けているか/型番や固有名詞を正確に検索できるか/メタデータで絞り込めるか/リランキングを行っているか |
| 権限 | ユーザーの権限を検索時に反映しているか/権限外の文書が生成AIに渡っていないか/権限による検索漏れを確認できるか/異動・退職時に権限が更新されるか |
| 評価 | 実際の業務質問でテストしているか/正解データが用意されているか/検索と回答生成を分けて評価しているか/回答できない質問もテストしているか/改善前後を比較しているか/ユーザーの評価や指摘を蓄積しているか |
運用設計まで含めて外に出す判断をするなら、発注前に見ておきたいのは進め方と費用の変わり方です。RAG開発の依頼先を探している方向けに、対応領域と進め方をまとめたページで、要件整理・検証・本番化の各段階と期間の目安を公開しています。
まとめ:RAGの精度が低いときは検索結果から確認する
RAGを導入しても回答精度が上がらない場合、原因は生成AIモデルだけにあるとは限りません。多くの場合、文書を正しく読み取れていない/文書の分割方法が適切でない/古い文書や重複文書が混在している/必要な情報を検索できていない/権限設定によって文書が除外されている/不要な検索結果を生成AIに渡している/回答品質を評価する仕組みがない、のいずれかに問題があります。
正しい文書が取得できていないのであれば、プロンプトや生成AIモデルを変更しても、根本的な改善にはなりません。RAGを業務で使えるレベルに高めるためには、文書分割、検索、メタデータ、権限、評価を一つの改善サイクルとして設計する必要があります。「社内文書を登録して終わり」ではなく、実際の質問と回答ログをもとに継続的に改善する。それが、社内FAQや問い合わせ対応、営業支援、ナレッジ検索で成果を生み出すRAG導入の重要なポイントです。
※ 本記事に登場する各クラウド・AIサービスのプロダクト名・サービス名はそれぞれの提供元の商標または登録商標です。仕様や提供形態は変更される可能性があるため、導入前に各提供元の最新情報をご確認ください。
よくある質問
カトルセの支援サービス
この記事の内容を自社で実践・定着させたい場合は、カトルセの法人向けサービスをご活用ください。人材育成から開発、社内定着の伴走までワンストップで支援します。