
機密情報を外に出さない生成AI。ローカルLLMのオンプレ構成と費用の目安【2026年10月版・Gemma 4対応】
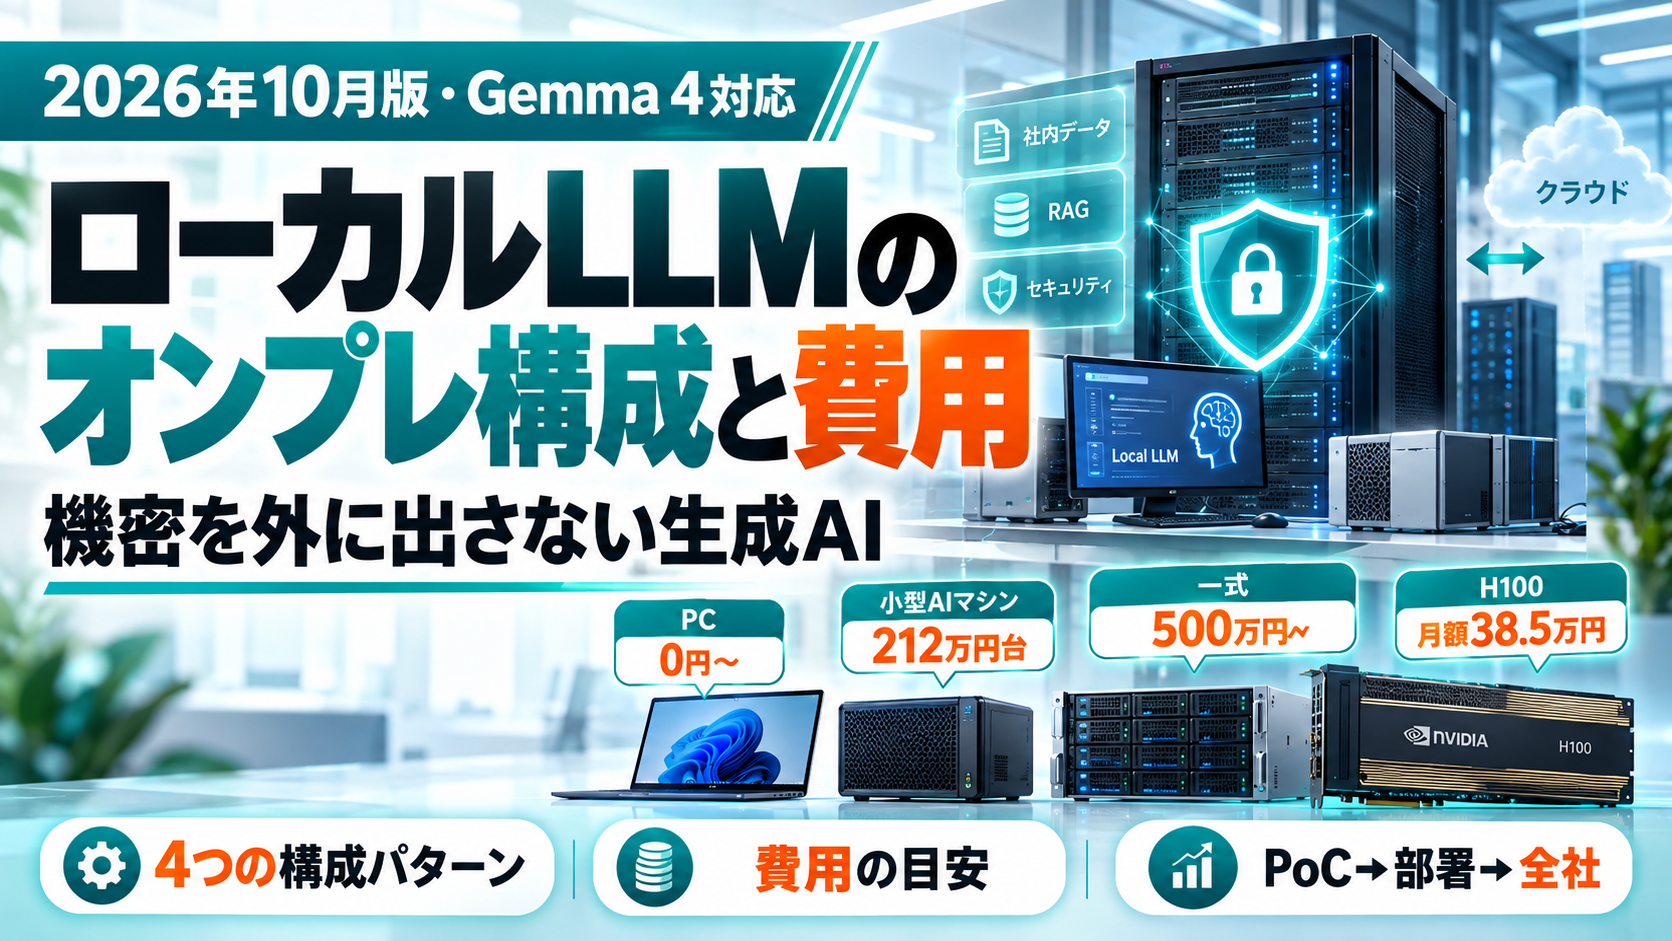
- 「全部ローカル」も「全部クラウド」も高くつきます。扱う情報の機密度で置き場所を分けるのが現実的です。
- 構成の基本形はPC1台/部署用の小型GPUサーバー/全社用GPUサーバー+社内文書検索(RAG)/クラウドのGPUを借りるの4つです。
- 2026年10月時点の価格の例:小型AIマシン(128GB)は国内で税込212万円台、GPUサーバー・LLM・RAGの一式は500万円〜(税別)、国内クラウドのH100 1枚は月額38万5,000円(税込)。機材は値上がり中です。
- 型の決まった業務なら精度は実用域。図面の細部などは実データで確かめ、PoC→部署→全社の順に広げます。
「社内の情報はクラウドに出せない。社内のサーバーでAIを動かしたいが、結局いくらかかるのか」。ローカルAI(ローカルLLM)のご相談で、最後に必ず出てくる質問です。
この記事は、法人が導入を判断するための構成パターンと費用の目安に絞ります。構成を考える前に、どの情報を社内に置くかの線引きが決まっている必要があります。規程・損害・利用頻度の3つの軸で置き場所を分ける考え方は、ローカルLLMの企業導入で最初に決めること(規程・費用・進め方)で整理しています。
- 半導体検査装置メーカーの工場(技術部門):機密情報のためクラウドは使えず、社内のGPUサーバーが前提。夜間・休日に上がる異常連絡票に、過去の事例からAIが自動で回答し、該当する事例がなければ担当者に連絡する仕組みがほしい。図面のデータベース化にも関心がある。来期の予算を今月計上する予定。
- 装置設計の会社:機密情報は、業者が構築したクローズドなGPT環境で扱っている。ただし、使える機能が限られている。
どちらも「外に出さない」ことは決まっていて、悩みは「どの構成で、いくらで、どこまでできるか」です。
1. 結論:「全部ローカル」でも「全部クラウド」でもなく、機密度で分ける
全社のAI利用を社内サーバーでまかなうと、全員分の処理能力をGPUでそろえることになり、費用も運用も膨らみます。逆に全部をクラウドにすると、図面や異常記録のような社外に出せない情報を扱えません。現実的なのは、情報を3つに分けて置き場所を変えることです。
| 情報の例 | 置き場所の候補 |
|---|---|
| 公開情報、社外向け文章の下書き、一般的な社内文書 | クラウドAI(企業向け契約) |
| 社外秘だが、契約上はクラウドの自社専用環境に置くことが許される情報 | 閉域・専用環境のクラウド |
| 契約・規程で社外に出せない情報(図面、設計情報、異常・品質記録、顧客ごとの技術資料、機密会議の録音) | 社内GPUサーバー、またはPC単体 |
ここからは、3段目を「社内で動かす」と決めたあとの話です。
2. 4つの選択肢:向き・不向き
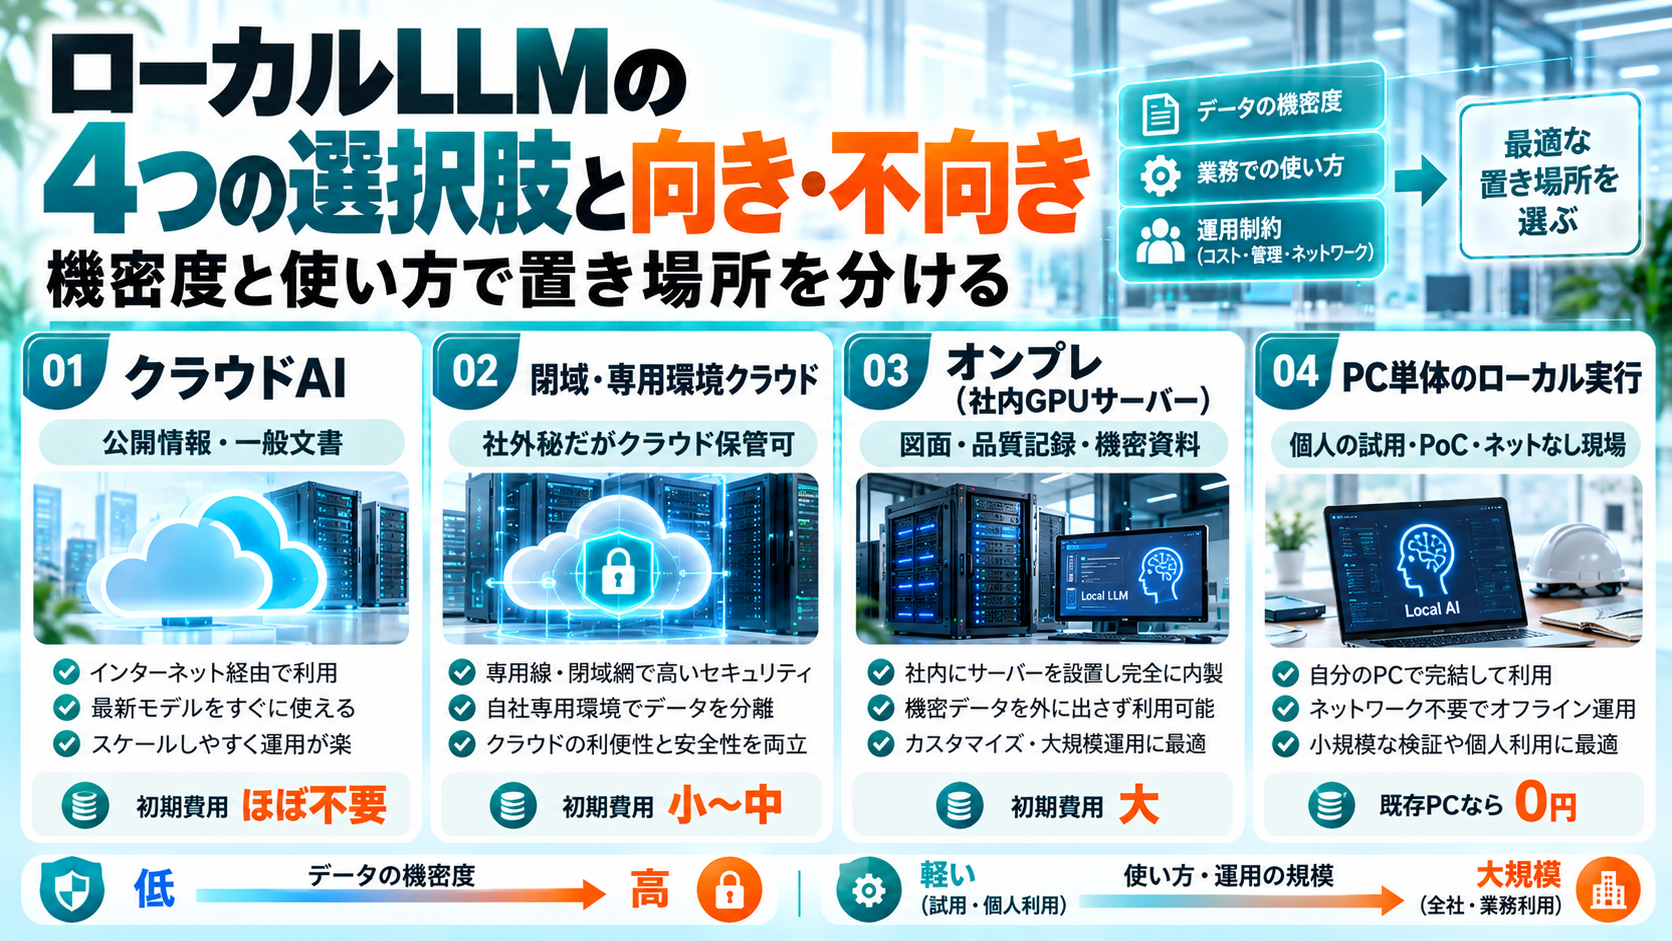
| 選択肢 | データの行き先 | 使えるモデル | 初期費用 | 向いている | 向いていない |
|---|---|---|---|---|---|
| クラウドAI(企業向け契約) | AI事業者のサーバー | 最新・最上位 | ほぼ不要 | 調査・企画・文章作成、一般的な社内文書 | 契約・規程で社外に出せない情報 |
| 閉域・専用環境のクラウド | クラウド上の自社専用環境 | 事業者が用意するもの | 小〜中 | 社外秘だがクラウド保管は許される情報 | クラウドに置くこと自体が禁止の情報 |
| オンプレ(社内GPUサーバー) | 社内 | 公開モデル(Gemma 4など) | 大 | 機密情報を毎日、複数人で使う業務 | 利用頻度が低い用途、最新性能が要る用途 |
| PC単体のローカル実行 | 手元のPC | 小〜中型の公開モデル | 小(既存PCなら0円) | 個人の試用、PoC、ネットにつながらない現場 | 複数人での共有、ログ管理が要る本番 |
閉域クラウドは「処理する地域」と「使える機能」を確認する
- 処理する地域:Microsoftの説明では、Azureでモデルを使う場合、デプロイの種類で処理する地域が変わり、「グローバル」型ではどのリージョンでも処理されることがあります。国内で処理したいなら、契約と設定の両方で確かめます。
- 使える機能:装置設計の会社の例のように、閉域環境では動くモデルや、ファイル読み込み・検索・画像の扱いが、契約や構築の範囲で決まります。契約前に、使いたい機能の一覧と照らし合わせておきます。
なお「学習に使われない」と「社外に出ない」は別の要件です。たとえばAWSは、Amazon Bedrockでは入力と出力をモデル提供者と共有せず、学習にも使わないと説明しています。ローカルが必要になるのは、社外に出すこと自体が禁じられている場合です。
3. 構成パターン4つと、必要な部品
部品は6つ
どの構成でも部品は同じで、違うのは大きさと台数です。
| 部品 | 役割と選び方 |
|---|---|
| GPU・メモリ | モデルを載せて計算する。必要量は「モデルの大きさ×圧縮の度合い」+「読ませる文書の長さ」+「同時に使う人数」で決まる |
| モデル | AI本体。Gemma 4などの公開モデルを、業務に足りる最小のものから試す |
| 推論ソフト | モデルを動かしAPIで呼べるようにする。1人ならOllamaやLM Studio、複数人ならvLLM(同時の依頼をまとめて処理し、OpenAI互換APIで呼べる) |
| 検索の仕組み(RAG) | 社内文書から関係する箇所を探してAIに渡す。文書の分け方と権限が精度を左右する |
| 利用画面 | Open WebUI、Difyなど。役割ごとの権限、社内の認証(LDAP・SSO)との連携を確認 |
| ログ・権限管理 | 誰が何を入力・出力したかを残す。文書の閲覧権限を検索結果にも引き継ぐ |
周辺ソフトにもライセンス条件があります。たとえばOpen WebUIは、30日間の利用者が50人を超える環境でロゴなどの表示を変えるには企業向けライセンスが必要です。
Gemma 4を載せるなら:大きさの目安
GoogleのGemma 4は2026年4月に公開され、6月に12Bが加わりました。ライセンスはApache 2.0で、商用利用できます。
| モデル | 必要なメモリの目安(モデル本体) | 一度に読める長さ | 音声入力 | 置き場所の例 |
|---|---|---|---|---|
| E2B/E4B | スマホ・ノートPC向けの小型 | 128Kトークン | あり(1回30秒まで) | PC単体 |
| 12B | 16GBのGPUメモリ、または統合メモリで動く | 256Kトークン | あり(1回30秒まで) | PC単体・部署サーバー |
| 26B A4B | 4bit:14.4GB/16bit:57.7GB | 256Kトークン | なし | 部署サーバー |
| 31B | 4bit:17.5GB/16bit:69.9GB | 256Kトークン | なし | 部署〜全社サーバー |
※ Googleが示すモデル本体の目安です。長い文書を読ませるほど、追加のメモリが大きく必要になります。16bitの26B A4B・31Bは、80GBのNVIDIA H100 1枚に収まるとGoogleは説明しています。
パターンA:PC1台で試す(個人・PoC)
| 機材 | 既存の業務PC(メモリ16GB程度)、または統合メモリの大きいPC(RTX Spark搭載ノート、Mac Studioなど) |
|---|---|
| モデル | 既存PCならE4Bや12B。統合メモリが大きいPCなら26B A4B・31Bも試せる |
| 推論ソフト・画面 | LM Studio、Ollama |
| 向く用途 | 個人の要約・下書き、機密会議の議事録、PoC |
| 弱点 | 人ごとに環境がばらばら。ログが残りにくい。紛失・持ち出しの管理が要る |
最初の検証はここで十分ですが、複数人で同じ文書を使う本番運用には向きません。
パターンB:部署用の小型GPUサーバー
| 機材 | GB10搭載の小型AIマシン(統合メモリ128GB。NVIDIA DGX Sparkや各社の同等機)、またはGPUメモリ96GBのRTX PRO 6000 Blackwellを積んだワークステーション |
|---|---|
| モデル | 26B A4B・31B(4bit〜8bit) |
| ソフト | vLLM+Open WebUIまたはDify。部署の文書に絞ったRAG |
| 向く用途 | 部署のFAQ、技術文書の検索、異常連絡票の一次回答 |
| 弱点 | 1台が止まると全員が使えない。同時に使う人が増えると待ち時間が延びる |
冒頭の工場の要望は、このパターンで始められます。構成の例です。
- STEP 1受付:夜間・休日に、異常連絡票が既存のフォームやシステムに登録される
- STEP 2検索:過去の異常連絡票・対応記録・手順書から、似た事例を探す(RAG)
- STEP 3判定:似た事例が見つかったかを、根拠の文書とあわせて判定する
- STEP 4回答:見つかれば、過去の対応内容と根拠の文書を添えて一次回答を返す
- STEP 5連絡:見つからない・判断が分かれるときは、AIは回答せず当番の担当者に連絡する
大切なのは、AIが「答えない」条件を先に決めておくことです。似た事例が見つからないときや安全に関わる異常は人に回すと決めておけば、誤った自動回答で現場が動くことを防げます。まず部署用の1台で始め、対象のラインや工場を広げる段階でパターンCに進みます。
パターンC:全社用GPUサーバー+社内文書検索(RAG)
| 機材 | 複数GPUのサーバー(止められない業務なら2台以上で冗長化)と、文書を保管・検索するサーバー |
|---|---|
| モデル | 31B(16bit)など。用途ごとに載せ分けることもある |
| 推論ソフト・画面 | vLLM+社内ポータルやDify。既存システムからAPIで呼ぶ |
| 認証・権限・ログ | 社内の認証(SSO・LDAP)と連携し、文書の閲覧権限を検索に引き継ぐ。入力・出力・参照文書を記録 |
| 向く用途 | 全社の規程・技術文書の検索、複数部署の定型業務 |
| 弱点 | 構築・運用の人手が最も大きい。更新と障害対応の担当が要る |
全社に広げるときに必ず問題になるのが権限です。全社に開くと、人事や設計の文書がAIの検索経由で見えてしまうことがあります。広げる前に、文書ごとの権限を検索に引き継ぐ設計を入れます。
パターンD:クラウドのGPUを専有で借りる
国内GPUクラウドのGPUを専有で借ります(例:さくらインターネット「高火力 VRT」のH100 80GB×1)。買う前にBやCと同じ構成で同時利用数と待ち時間を測る、繁忙期だけ増やす、といった使い方に向きます。クラウドに置くこと自体が規程で禁止なら使えません。
4. 費用の目安(2026年10月時点)
各社の公式発表と報道で確認できた価格の例です(カトルセ独自の価格ではありません)。構成や時期で大きく変わるため、幅の目安としてご覧ください。
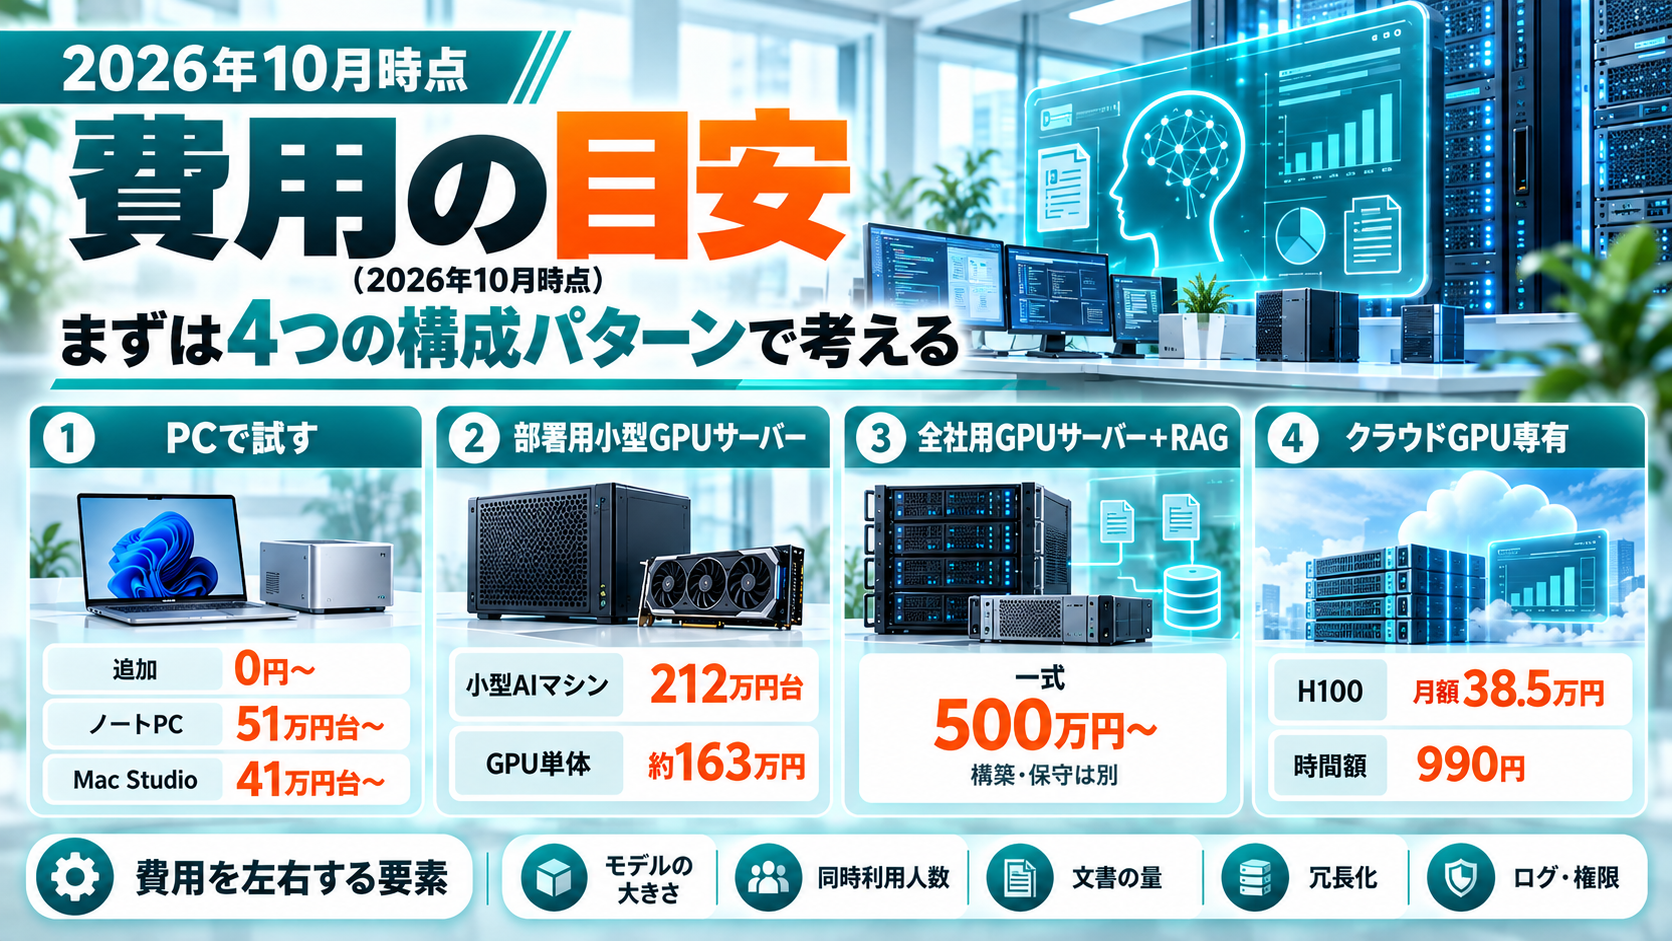
| 区分 | 価格の例(2026年10月時点) | 出典 |
|---|---|---|
| PC(パターンA) | 既存の業務PC:追加0円 RTX Spark搭載ノート(Surface Laptop Ultra):24GBモデル 51万3,480円〜、128GBモデル 約109万円(税込) Mac Studio:M5 Max搭載 41万9,800円〜、M5 Ultra搭載 94万9,800円〜 | テクノエッジ、PC Watch |
| 小型AIマシン(パターンB) | GB10搭載・メモリ128GB/4TB構成:税込212万5,200円(希望販売価格)、Dell直販の同構成:税込214万820円 | テクノエッジ |
| GPU 1枚(パターンB・C) | RTX PRO 6000 Blackwell(GPUメモリ96GB):2025年5月の国内発売時の店頭価格 約163万円(GPU単体) | AKIBA PC Hotline! |
| 構築・保守(ハードウェア別) | Ollamaでの構築 104万円〜・年額保守 26万2,000円〜 Difyでの構築 147万円〜・年額保守 32万3,000円〜(いずれも税別。デージーネットの社内AI基盤構築サービス) | クラウド Watch |
| GPUサーバー+LLM+RAGの一式(パターンC) | 参考価格 500万円〜(税別。インテックのローカルLLM導入支援。最短1か月で構築) | インテック |
| クラウドのGPU専有(パターンD) | H100 80GB×1:月額38万5,000円、時間額990円(税込) | さくらインターネット |
機材は値上がりが続いている
2026年は、メモリの供給不足で機材の価格が上がっています。NVIDIAは10月2日、小型AIマシン「DGX Spark」のFounders Edition(128GB)を、メモリの供給制約とコスト上昇を理由に6,950ドルへ改定しました(発売時は3,999ドル)。同じ記事は、国内の販売価格が為替換算の額(税込で約120万6,000円)を大きく上回ると指摘しています。見積もりは取得日と有効期限を控えて比べます。
見積もりの考え方:費用を決める7つの要素
- モデルの大きさ:大きいほどGPUメモリが要ります。
- 同時に使う人数:総数ではなく、忙しい時間帯に同時に依頼を投げる人数です。
- 読ませる文書の長さと量:長いほどメモリを使い、多いほど保管と更新の手間が増えます。
- 止まってよいか:止められない業務なら冗長化が要り、機材は倍になります。
- 権限・ログ・認証の連携:全社に広げるほど設計と構築の費用が増えます。
- 運用の人手:モデルの更新、障害対応、権限の棚卸し。毎月かかります。
- 設置場所:電源、冷却、ラック、保守契約。
たとえば上の表のH100 1枚を月額のまま1年借りると462万円(税込)です。機材は数年使えますが、運用の人手と電気代が毎月かかります。使う量が多いほど購入が有利、少ないうちは借りるほうが有利です。
5. 精度の限界と、クラウドとの使い分け
日本語:型の決まった業務は実用域。仕上げはクラウドが強い
Gemma 4は140以上の言語で学習され、Googleのモデルカードでは35以上の言語にそのまま対応するとしています。実務では、要約・分類・社内文書の検索回答のように型が決まった処理は実用的です。長い推論や社外向け文章の仕上げは、クラウドの上位モデルとの差が出やすい領域です。判断は自社の実データで比べて行います。
長い文書:読める長さより「メモリ」と「探し方」
12B以上は一度に256Kトークンまで読めますが、長く読ませるほど追加のメモリが要ります。複数人で使うサーバーでは、全文を渡すより、RAGで関係する箇所だけを渡すほうが速く、安く済みます。
図面・画像:読み取りはできる。細部は実物で確かめる
モデルカードによれば、Gemma 4は文書・PDFの読み取り、図表の理解、多言語の文字読み取り(OCR)、手書き文字の認識に対応しています。ただし図面は、細かい寸法・記号・注記が詰まった難しい素材です。表題欄や部品表など決まった場所から読ませる、分割して拡大して読ませる、CADデータの文字情報と組み合わせる、といった工夫を前提に、自社の図面で精度を確かめます。
音声:長い会議は音声認識と分担する
Gemma 4の音声入力はE2B・E4B・12Bで使え、1回30秒までです。議事録は「音声認識のモデルで文字にする→LLMで要約する」と分担する構成が現実的です。
業務ごとの置き場所の目安
| 業務 | 置き場所の目安 | 理由 |
|---|---|---|
| 社外向け文章の仕上げ、調査・企画 | クラウド(企業向け契約) | 上位モデルが強い。公開情報が中心 |
| 社内規程・手順書の検索回答 | 閉域クラウドまたは社内サーバー | 規程の機密度で決める |
| 異常・品質記録、技術文書の検索 | 社内GPUサーバー | 社外に出せず、毎日使う |
| 図面の読み取り・検索 | 社内GPUサーバー+専用の検索 | 取引先との契約で出せないことが多い |
| 機密会議の議事録 | PC・端末内 | 録音を外に出さない |
6. 導入の進め方(PoC→部署→全社)と、決めておく運用
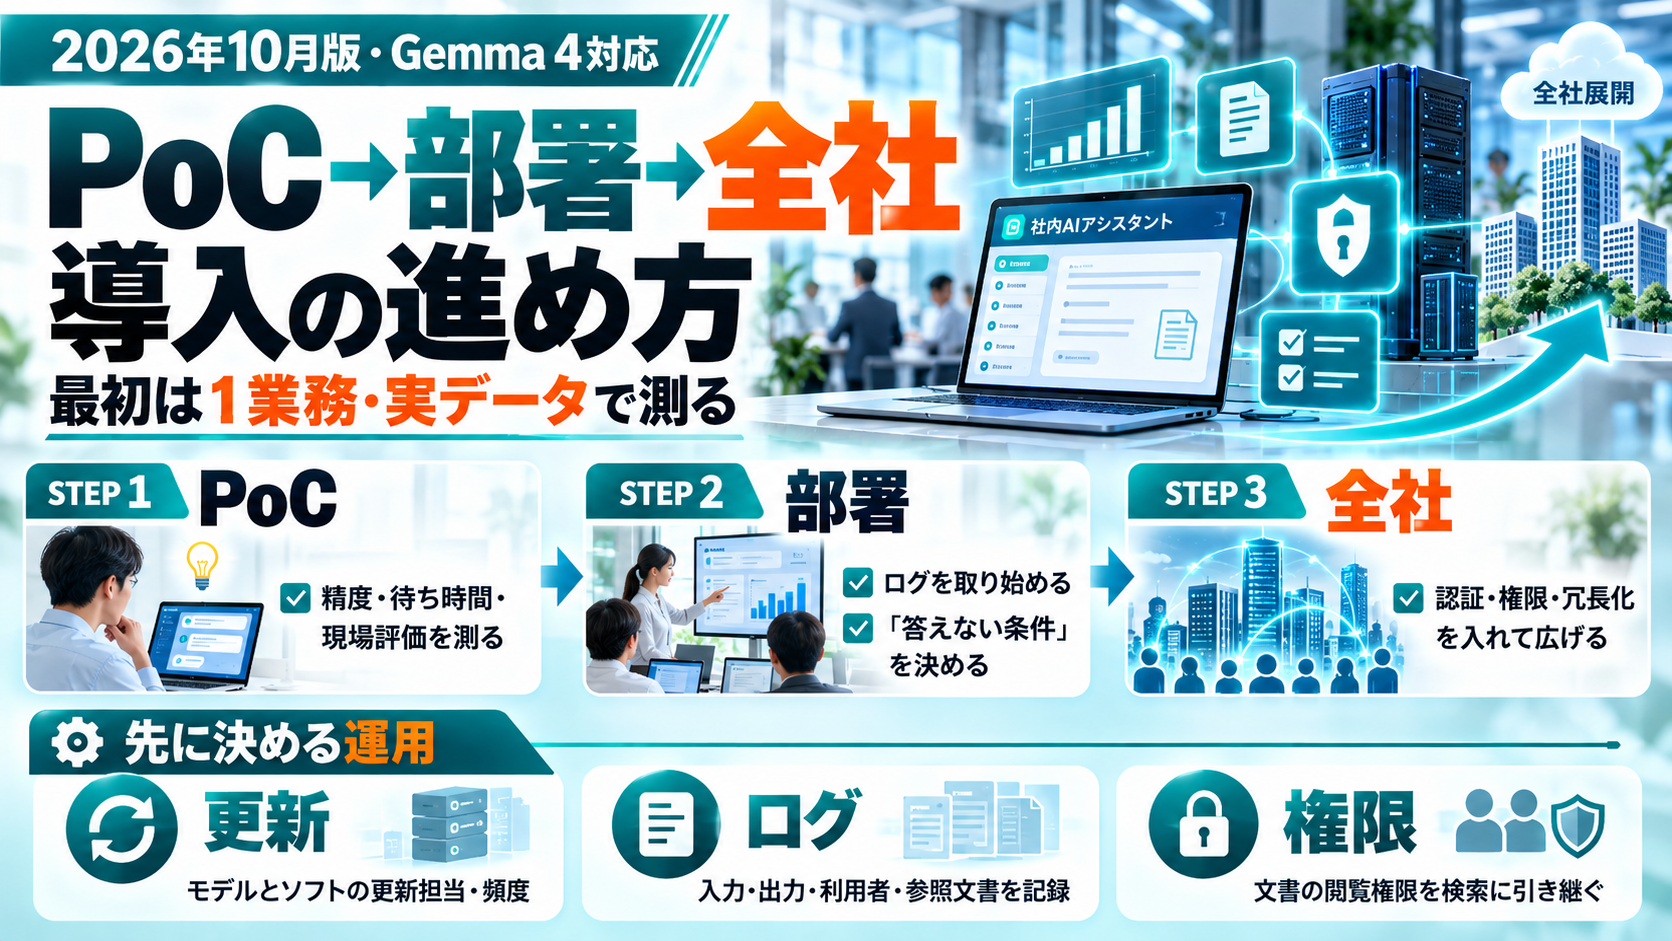
- STEP 1PoC(パターンAかD):1業務・実際の文書で、精度・待ち時間・現場の評価を測る。「同時に使う人数」と「文書の量」の数字を出し、見積もりの前提にする
- STEP 2部署(パターンB):利用者を部署に限り、ログを取り始める。「答えない」条件と担当者への連絡を、運用で回してみる
- STEP 3全社(パターンC):認証・文書ごとの権限・冗長化を入れてから、対象を広げる
決めておく運用:更新・ログ・権限
| 項目 | 決めること | 担当と頻度の例 |
|---|---|---|
| モデルの更新 | 誰が評価し、いつ切り替えるか。評価用の質問と正解のセットを残す | 情シス+利用部門。半年〜1年に1回 |
| ソフトの更新 | 推論ソフト・利用画面の脆弱性への対応 | 情シス。月1回の確認 |
| ログ | 入力・出力・利用者・参照文書を記録。保存期間と閲覧できる人 | 情報セキュリティ担当。規程で定める |
| 権限 | 文書の閲覧権限を検索に引き継ぐ。異動・退職を反映 | 文書を持つ部門。異動のたび |
| 公開範囲 | 社内ネットワークからだけ接続。外から使うなら認証を前に置く | 情シス。構築時と変更時 |
社内で動かしていても、設定の誤りや権限の漏れで事故は起きます。ログと権限の担当は、構築を始める前に決めておきます。
7. ニュース:クラウドを使わず、手元でAIを動かす流れ(2026年10月)
- 10月16日:NVIDIAが「RTX Spark」搭載のWindowsノートPCの販売開始を発表。ASUS・Dell・HP・Lenovo・Microsoft・MSIから、米国価格2,599ドルからです。最大128GBの統合メモリで、大規模言語モデルやAIエージェントを手元で動かせるとしています。小型デスクトップは11月の予定です。
- 10月2日:NVIDIAが「DGX Spark」に64GB版(4,999ドルから、10月23日からPCメーカー6社が販売)を加え、128GB版のFounders Editionを6,950ドルに改定しました(PC Watch)。
「まずPCで試す」ハードルは下がりましたが、機材は値上がりしています。複数人で文書を共有し、ログと権限を管理するならサーバー側の構成が要る点は変わりません。
8. カトルセの支援
ローカルAI議事録:会議から始める
機密の会議は、外に出せない情報の代表です。カトルセのローカルAI議事録は、録音・文字起こし・議事録の作成・AIへの相談・保存を、スマホやPCの端末の中で完結させる会議支援パッケージです。ローカルLLMと音声認識モデルを組み合わせ、暗号化保存・削除ポリシー・監査ログ・端末管理(MDM)まで運用を設計します。1つの会議体・1部署・数台の端末から始められます。
AI開発:成立するかを先に確かめる
社内GPUサーバーでのRAGや異常連絡票の一次回答のような仕組みは、生成AI開発でご相談いただけます。相談(60分)→要件整理(2〜3週)→検証(PoC、3〜6週)の順で「成立するか」を先に確かめ、成立しなければそこで止められます。ローカルLLM・プライベート環境での構成と権限設計を最初から入れ、要件定義書・テスト観点表・運用手順書をお渡しします。社内に閉じた環境でRAGや議事録の仕組みを組んだ実例は、AI開発事例(ローカルLLM・RAG・議事録)にまとめています。
運用の伴走
導入後の運用ルールづくりと社内展開は、AI顧問として伴走します。
よくある質問
社内GPUサーバーを1台買えば、全社でChatGPTのように使えますか?
使う人数とモデルの大きさ次第です。1台のサーバーで同時に処理できる量には上限があり、利用者が増えるほど待ち時間が延びます。まず部署単位で、同時に使う人数・読ませる文書の長さ・応答時間を実測し、その数字から全社の台数と構成を決めるのが確実です。
ローカルLLMで図面を読ませることはできますか?
読み取り自体はできます。Gemma 4は画像の文字読み取りや、文書・図表の読み取りに対応しています。ただし図面は細かい寸法や記号が詰まっているため、精度は自社の図面で確かめる必要があります。類似図面の検索や図面のデータベース化は、読み取りとは別の仕組みを組み合わせて設計します。
クラウドとオンプレは、どちらが安いですか?
使う量で逆転します。クラウドは使った分だけかかり、オンプレは機材と運用の費用が使わなくてもかかります。毎日大量に使う定型業務ほどオンプレが有利になり、月に数回の用途はクラウドが有利です。比較には、月間の処理件数、1件あたりの文書の長さ、求める応答速度の3つの数字が必要です。
Gemma 4は業務で使ってよいライセンスですか?
Gemma 4はApache 2.0ライセンスで公開されており、商用利用できます。ただし、推論ソフトや利用画面など周辺のソフトにもそれぞれライセンス条件があります。導入前に、構成に含まれるすべてのソフトの条件を確認してください。
まとめ ── 「外に出さない」は決まっている。次は構成と数字
- 置き場所は機密度で分ける。社外に出せない情報だけを社内で動かせば、費用と運用は現実的な範囲に収まります。
- 構成は4つの基本形から選ぶ。PC1台で試し、部署用サーバーで回し、権限とログを整えてから全社に広げます。
- 費用は「同時に使う人数」と「文書の量」で決まる。機材は値上がり中です。PoCで数字を出してから見積もりを取ります。
異常連絡票への一次回答も、図面のデータベース化も、最初の一歩は「1業務・実際のデータで測る」ことです。
自社の現在地を確かめる
ローカルLLMの構成を決める前に、社内でAIがどこまで使われているかを把握しておくと、PoCで測る業務を選びやすくなります。生成AI活用レベル診断(10問・無料)で、個人と組織の現在地と次にやることが分かります。
※ 本記事の内容は2026年10月時点の情報にもとづいています。価格・仕様・ライセンス条件は、本文中にリンクした各社の公式ページと報道で2026年10月17日に確認したものです。機材の価格は為替とメモリの需給、販売店や構成で大きく変わります。判断の際は最新の公式情報と見積もりをご確認ください。製品名・サービス名は各社の商標または登録商標です。